
Day 05 講完它怎麼從你的話裡推論出任務. 既然是推論, 流傳的 prompt 技巧就分兩種: 有些在幫它推對, 有些只是安慰你自己. 這題被寫過一萬次, 所以這篇不列「10 個必學技巧」, 只做一件事: 把常見技巧拿去對證據, 再用 Day 01 的原理解釋為什麼.
不管哪一派, 好 prompt 的骨架都是同樣四件事:
| 要素 | 在回答什麼 |
|---|---|
| 指令 (instruction) | 要做什麼 |
| 脈絡 (context) | 背景、限制、你是誰 |
| 輸入資料 (input data) | 要處理的東西 |
| 輸出格式 (output format) | 希望長什麼樣回來 |
這四格填滿, 你就已經贏過八成的人. 剩下的全是邊際優化, 而且有些邊際優化根本不存在.
下面是一個把四格全填齊、可以直接複製改的通用範本. 用 XML 標籤把每一格框起來, 是 Anthropic 官方 prompt engineering 指南推薦的寫法, 也是《The Prompt Report》(Schulhoff et al., 2024) 篩了 1,565 篇論文、整理出 58 種技巧後最常出現的一種結構:
你是資料整理助手, 幫使用者把長內容濃縮成可執行的重點.

<task>
把下面的會議記錄整理成三點行動項目.
</task>

<transcript>
(把會議逐字稿貼在這裡)
</transcript>

<format>
三點, 每點以動詞開頭, 附責任人; 沒有明確責任人寫 TBD.
</format>
對應到四件事:
<task> 裡的一句話<transcript> 區塊<format> 區塊開頭「你是資料整理助手」看起來像角色扮演, 但那是脈絡格的最短寫法, 是在講「這是整理類任務」. 跟下面會講到「角色扮演沒用」不衝突, 那條講的是吹履歷式人設 (「你是 10 年經驗的資深工程師」), 而且限客觀題; 這裡是指定任務類型, 屬於下面那條「仍然有用」的例外.
58 這個數字本身就說明問題: 技巧多到這種程度, 代表沒有幾個是真的關鍵. 上面這個範本就已經吃掉大部分.
一、給範例 (few-shot), 最穩的一招.
當你要的格式很難用文字描述時, 直接給一到三個範例, 比寫五百字說明有效得多. 原因 Day 05 已經講過: 任務座標是從你的話裡算出來的, 範例是你操作那個座標最直接的介面. 給模式, 比給形容詞準.
放到上面那個範本上, 就是在 <task> 前面多插一個 <example> 區塊, 貼一份「輸入 → 期望輸出」給它看.
二、明確的輸出格式與長度.
「用 JSON」「三點, 每點不超過 30 字」這類可驗證的約束, 它照做的機率高很多. 反過來, 「詳細一點」這種模糊詞幾乎沒有效果.
三、把「指令」和「資料」分開.
用標籤或明確標題隔開, 避免資料裡的文字被當成指令讀. 這同時是防 prompt injection 的第一層.
這一段才是這篇的重點.
「你是一個有 10 年經驗的資深工程師」, 大概是最多人用、也最少人查證的一招.
Day 05 已經講過為什麼: 人設動的是語氣那一層, 動不到「它推成什麼任務」那一層. 今天補上證據.
EMNLP 2024 的研究 (Zheng et al.) 做得很徹底: 整理 162 種角色 (涵蓋 6 種人際關係、8 個專業領域), 在 4 個模型家族上測 2,410 道事實題. 結論是: 加角色並沒有讓表現變好.
注意範圍, 這測的是客觀任務 (有標準答案的). 當「換一種說法」本身就是你要的東西時, 人設仍然有用. 這時它是在指定任務, 不是裝飾語氣 (這個區別 Day 05 拆得更細).
(jason3e7) 誠實補一句: 我自己四月寫的筆記裡, 好 prompt 的結構第一行就是「角色設定」.
「我會給你 200 美元小費」「這對我的職涯很重要」「答錯我就要被開除了」.
Wharton 的 Prompting Science Report 3 (2025, 標題直白得可愛: I'll pay you or I'll kill you — but will you care?) 在 5 個模型上用博士級題目測了給錢與威脅, 沒有可觀察到的效果.
那 2023 年那篇「情緒提示提升 10.9%」的研究呢? 問題出在算法, 那個數字是每題挑表現最好的那個情緒句算出來的. 改成把所有情緒句平均, 提升掉到 BIG-Bench 上 4.42%、整體 2.58%, 而且方向並不穩定.
一個好用的判準: 任何「咒語型」技巧, 先問它是不是挑最好的那一次算出來的.
「Let's think step by step」曾經是最有名的一句咒語. Wharton 在 2025 年 6 月的報告測下來:
| 模型類型 | 加 CoT 的效果 |
|---|---|
| 推理模型 (會自己思考的) | 幾乎沒有提升, 但時間多花 20 到 80% |
| 一般模型 | 平均小幅提升, 但答案的變異變大 (同一題, 結果更不穩定) |
原因很直白: 推理模型的「一步一步想」早就被訓練進去了, 你再叫它一次是重複勞動.
這條的心法比技巧本身重要: 一個技巧有沒有效, 取決於你用的是哪一代模型. Day 02 那條四到七個月翻一倍的曲線, 也在淘汰技巧.
把三段擺在一起, 規律很清楚, 而且全部能從 Day 01 推出來:
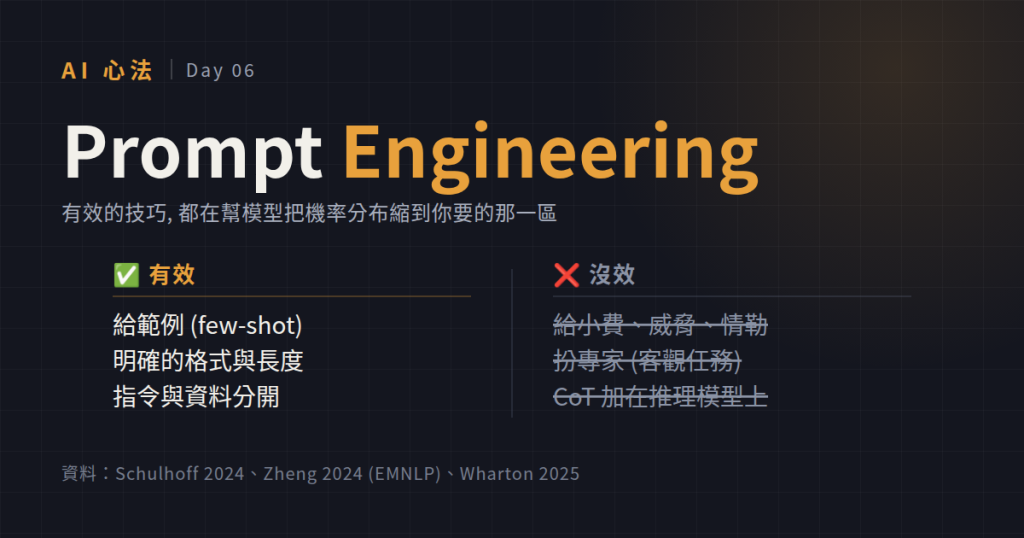
| 技巧 | 有效嗎 | 為什麼 |
|---|---|---|
| 給範例 | ✅ | 它就是在接續模式, 給模式最直接 |
| 明確格式與長度 | ✅ | 把機率分布縮到你要的那一區, 而且可驗證 |
| 指令與資料分開 | ✅ | 讓它分得清哪些是要做的、哪些是要處理的 |
| 角色扮演 | ⚠️ 只在轉換類 | 改的是語氣分布, 不是任務 |
| 給小費/威脅 | ❌ | 沒有改變任何有用的機率 |
| CoT 用在推理模型 | ❌ | 它本來就已經在做了 |
一句話收:
有效的技巧, 都是在幫它把機率分布縮到你要的那一區; 沒效的技巧, 是在對一台機率機器講人話.
它不會因為你說「這很重要」就更努力, 它沒有「努力」這個檔位.
最後留一個更大的: prompt 只是它看到的東西的一小部分. 你以為你在調的是那句話, 但真正決定輸出的, 是它這一輪看到的全部內容, 系統提示、前幾輪對話、你貼的檔案、工具回傳的結果都算.


 iThome鐵人賽
 看影片追技術